ЛИНЕЙКА AI-СИСТЕМ · СОСТАВ И НАЛИЧИЕ УТОЧНЯЮТСЯ ПЕРЕД ЗАКАЗОМ

Конфигурация сервера / GPU-системы

AI-сервер на 2 GPU

Сервер на два ускорителя часто становится базовой точкой для локального inference, разработки и независимых GPU-задач. При планировании проверяются PCIe-линии, память каждой карты и возможность последующего расширения.

Подбор зависит от точного SKU, количества GPU, межсоединения, питания и охлаждения серверного шасси.

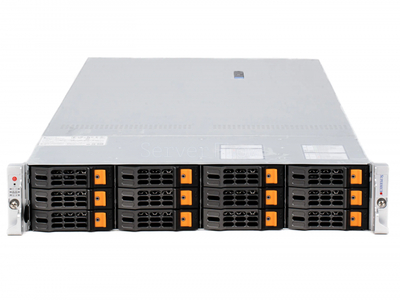
OEM-пример серверной платформы для AI-серверы на 2 GPU из каталога ServerFlow
Иллюстративный OEM-пример из каталога ServerFlow; точную модель корпуса и комплектацию сверяем отдельно. Источник: ServerFlow ↗

AI Server Lab / ПОДБОР СИСТЕМЫ

AI-сервер на 2 GPU: конфигурация под нагрузку

Запрос «сервер на 2 GPU» описывает масштаб узла, но сам по себе не задаёт его производительность. Нужно выбрать ускорители, межсоединение и серверную платформу с подходящими линиями PCIe, питанием и охлаждением; ориентир по корпусу — Tower или rack — зависит от плат, CPU, слотов PCIe и охлаждения. Поэтому такую конфигурацию рассматриваем как основу подбора, а не как фиксированный SKU.

Для узла на 2 GPU отдельно проверяют, поддерживает ли корпус нужные карты, остаются ли доступными линии PCIe и хватает ли охлаждения при одновременной нагрузке. Увеличение числа GPU не гарантирует линейный прирост: его ограничивают межсоединение, CPU, память, хранилище и сеть.

Типовые сценарии

  • прототипирование
  • inference
  • рендеринг и компактные GPU-узлы
ПЕРЕД ПОДБОРОМ / GPU-системы

Какие параметры фиксируем

  • Точная модель ускорителя или платформы
  • Число GPU и схема межсоединения
  • CPU, RAM, сеть и накопители
  • Питание, охлаждение и место установки
Перейти к характеристикам ↓

МОДЕЛЬ И ПЛАТФОРМА

Характеристики AI-серверы на 2 GPU и требования к системе

Ниже — ключевые параметры модели и пункты, которые стоит проверить до запроса коммерческого предложения.

01 / ARCHITECTURE

Архитектура и роль в системе

Конфигурация строится вокруг выбранного GPU и задач; для карт с NVLink/Infinity Fabric совместимость платформы подтверждается отдельно.

Сервер на два ускорителя часто становится базовой точкой для локального inference, разработки и независимых GPU-задач. При планировании проверяются PCIe-линии, память каждой карты и возможность последующего расширения.

02 / WORKLOAD

Нагрузки и сценарии применения

Прототипирование, inference, рендеринг и компактные GPU-узлы.

Для узла на 2 GPU отдельно проверяют, поддерживает ли корпус нужные карты, остаются ли доступными линии PCIe и хватает ли охлаждения при одновременной нагрузке. Увеличение числа GPU не гарантирует линейный прирост: его ограничивают межсоединение, CPU, память, хранилище и сеть.

03 / COMPATIBILITY

Что проверить до заказа

Модель GPU, длину плат, линии PCIe, мощность блока питания, airflow и резерв для роста.

В предложении фиксируют точную модель, количество ускорителей, платформу, сеть, питание и охлаждение. Это позволяет сравнить технически сопоставимые варианты и проверить их для вашей площадки.
01 / ЗАДАЧА

Опишите нагрузку

Размер модели, контекст, пользователей и требование к скорости помогают определить нужный объём памяти и число ускорителей.

02 / ПЛАТФОРМА

Уточните вариант

Суммарная память — удвоенный объём выбранной модели GPU; память не всегда объединяется автоматически. Сопоставьте это с форм-фактором: Tower или rack — зависит от плат, CPU, слотов PCIe и охлаждения.

03 / ПЛОЩАДКА

Проверьте инфраструктуру

Модель GPU, длину плат, линии PCIe, мощность блока питания, airflow и резерв для роста. Также подтвердите сеть, электропитание, отвод тепла и доступное место в стойке.

ВОПРОСЫ ПО МОДЕЛИ

Частые вопросы: AI-серверы на 2 GPU

Коротко отвечаем о применении, комплектации и формировании предложения.

Как выбрать AI-сервер на 2 GPU под задачу?

Начните с модели GPU, размера модели, числа одновременных задач и требуемой связности карт. Такой масштаб узла подходит, когда нагрузке нужна соответствующая параллельность и пропускная способность.

Означает ли число GPU, что память объединится?

Нет. Суммарная память — удвоенный объём выбранной модели GPU; память не всегда объединяется автоматически. Для совместной работы ускорителей отдельно проверяют топологию PCIe, NVLink или другого межсоединения и поддержку со стороны ПО.

От чего зависит цена AI-сервера на 2 GPU?

От точной модели и количества ускорителей, OEM-платформы, CPU, объёма RAM, накопителей, сети, питания, охлаждения и условий поставки. Сравнивать предложения корректно по одной спецификации и одинаковым условиям гарантии.

AI SERVER LAB / CONFIGURATION

Подберём сервер под вашу нагрузку

Модель уже будет указана в форме. Добавьте задачу и ограничения площадки — подготовим вариант конфигурации для обсуждения.

Обсудить задачу ↗