01 / ARCHITECTUREАрхитектура и роль в системе
Hopper, Tensor Core и NVLink в поддерживаемых платформах. Высокая ёмкость памяти полезна, когда модель и контекст должны размещаться в GPU-памяти.
Hopper-ускоритель с увеличенной HBM3e-памятью для крупных моделей, которым тесно в 80-гигабайтном классе. На практике итог зависит от связности GPU, CPU, сети и профиля модели.
02 / WORKLOADНагрузки и сценарии применения
Инференс крупных LLM, обучение и дообучение моделей, HPC с интенсивным обменом данными.
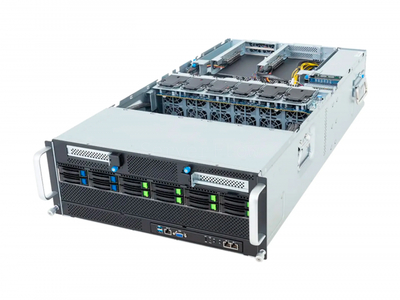
При проектировании сервера с NVIDIA H200 важно не складывать только паспортные показатели отдельных карт. Память GPU обычно остаётся распределённой по ускорителям, а скорость совместной работы зависит от PCIe, NVLink и NVSwitch. В техническом задании полезно указать размер модели, контекст, число параллельных запросов и ожидаемую нагрузку на обучение или инференс.
03 / COMPATIBILITYЧто проверить до заказа
Память 141 ГБ относится к SXM; проверить вариант платы, тепловой режим, топологию NVLink/NVSwitch, стойку и доступную мощность.
В предложении фиксируют точную модель, количество ускорителей, платформу, сеть, питание и охлаждение. Это позволяет сравнить технически сопоставимые варианты и проверить их для вашей площадки.